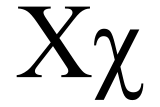viernes, 11 de enero de 2013

Bibliografía para la enseñanza de hidráulica y obras hidráulicas

La enseñanza del diseño y marco conceptual de hidráulica y obras hidráulicas es complejo aquí y en el mundo desarrollado (imágen: Sabiduría ancestral de las culturas prehispánicas de Moxos)
. La prueba es uno de los artículos que abren una de las ediciones especiales del Journal of Hydraulic Engineering de diciembre de 2001, titulado Bibliografía para la Enseñanza de Diseño Hidráulico, de Jack Cook. 

Escribo esta entrada para cerrar el ciclo 2012 del curso correspondiente a Hidráulica Aplicada (la segunda materia impartida por mi persona) invitándoles a revisar la bibliografía comentada en esta prestigiosa revista. Allí se darán cuenta que los textos principales allí revisados fueron cubiertos en clase. Este hecho demuestra la calidad del curso impartido, y constituye un beneficio personal traducido en un beneficio directo a todos mis estudiantes. Un saludo y un gran año 2013!

El artículo lo tienen en el siguiente link. Lo introduje aquí considerando que cualquiera de ustedes estimados lectores pueden registrarse en la Revista mencionada para tener acceso libre a cinco artículos de la misma. De esta manera asumo que no incurro en violaciones a los derechos de autor correspondientes.

Cualquier comentario acerca de este u otro contenido pueden introducirlo en los comentarios. Con gusto serán atendidos.

jueves, 4 de octubre de 2012

DISTRIBUCIÓN NORMAL Y LOGNORMAL CON EXCEL-Juan


INTRODUCCIÓN

Todos los eventos en la naturaleza, tiene un número asociado a su ocurrencia, este valor indica la probabilidad de  que el evento ocurra; pero aunque el evento tenga alta probabilidad de ocurrencia puede ser que no suceda y viceversa.

La probabilidad estimada o probabilidad empírica de un evento es la frecuencia relativa de ocurrencias del evento, cuando el número de observaciones es muy grande. La probabilidad es el límite de la frecuencia relativa, conforme el número de observaciones crece en forma indefinida (Spiegel y Stephens, 2002).

miércoles, 3 de octubre de 2012

Bondad de Ajuste-Anderson Darling.Juan


INTRODUCCIÓN
Todos los elementos en la vida real están relacionados unos a otros, es imposible pensar que u elemento en la cotidianeidad esta completamente aislado; por tanto existe una interacción entre los diferentes componentes de un sistema, ya sea con el interior del sistema o con el exterior del sistema considerando las condiciones de borde.

miércoles, 26 de septiembre de 2012

Distribuciones Exponencial y Chi2-FreddyA.

a) Introducción
En teoría de la probabilidad y estadística, la distribución de probabilidad de una variable aleatoria es una función que asigna a cada suceso definido sobre la variable aleatoria la probabilidad de que dicho suceso ocurra. La distribución de probabilidad está definida sobre el conjunto de todos los sucesos y cada uno de los sucesos es el rango de valores de la variable aleatoria.

Medidas de Distibución - Asimetría y Curtosis


Figura 1. Diagramas esquemáticos de la probabilidad de densidad de funciones
Las medidas como la media, la desviación estándar y el coeficiente de asimetría de un conjunto de datos, que caracterizan a la ubicación central, dispersión y asimetría de su histograma, son estimaciones de la muestra de la estadística propiedades del fenómeno estudiado. Además de la tendencia central y la variación, las medidas de Asimetría y la Curtosis, nos permiten describir una distribución de frecuencias (Kottegoda, N. y Rosso, R. , 2008).

Para acceder a mayor información, por favor ingrese a este link:

Distribución Weibull-Claudia


Según Gil Mollá el uso de la función de distribución de Weibull en los estudios defiabilidad de componentes se debe principalmente a la gran diversidad deformas.que este  modelo puede tomar, dependiendo de los valores de los parámetros característicos. Esto nos permite usar un mismo modelo, independientemente de en qué forma varíe la tasa de fallos del componente estudiado, simplificando en gran medida la tarea de análisis de los resultados.Si no usáramos este modelo, cualquier análisis de los resultados obtenidos durante el ensayo de los componentes implicaría necesariamente un estudio previo de los datos, para determinar cuál de los diferentes modelos existentes se asemeja más a los datos obtenidos. Esto conllevaría un mayor  tiempo de análisis y una mayor probabilidad de error, debido a que una mala elección del modelo implicaría dar un resultado erróneo. Al aplicar Weibull, el estudio previo de los datos se reduce únicamente a una inspección visual en busca de posibles datos anómalos que distorsionen los resultados. 


Fig. Relación entre la probabilidad acumulada de fallo ( Fi ) y el tiempo o ciclos de cada muestra (ti)

Para mayor información por favor seguir el siguiente link: 
https://docs.google.com/open?id=0B2N4yDI7CgUha3NkUFExMXVoNlU


martes, 25 de septiembre de 2012

MANUAL DE SAS BÁSICO-FreddyR.


El link que se presenta, es del Manual SAS Básico para la consulta de los estudiantes del Curso.

En el siguiente link pueden encontrar mayor información.

https://docs.google.com/open?id=0B8yX5UI0dhh0WFRPelF0eHduTkk

Método Jackknife y Bootstrap-Claudia

Los métodos de Jackknife y Bootstrap, son métodos de remuestreo, utilizados para la corrección de bias. En 1949 Quenouille propuso el método de jackknife para estimar bias, posteriormente en 1958 Tukey aplicó la técnica de “jackknife” para estimar errores estándar. En 1979 B. Efron publicó el método de bootstrap. 


El link para acceder a mayor información lo pueden encontrar aquí:
https://docs.google.com/open?id=0B2N4yDI7CgUhR3lOZm41SGRGRHM

El link para acceder al ejemplo lo pueden encontrar aquí:
https://docs.google.com/open?id=0B2N4yDI7CgUhSnFfS241ZEpTRnM


jueves, 20 de septiembre de 2012

TEST SHAPIRO WILK-Marco

1.      INTRODUCCIÓN

El problema general para la determinación de la distribución de procedencia de los datos es tan antiguo como complejo y, en la Estadística se le suele llamar “Prueba de bondad de ajuste” o “ajuste de curvas”. Su planteamiento general está relacionado con las pruebas de hipótesis. El problema de ensayar la bondad de ajuste de las distribuciones teóricas a las distribuciones maestrales es esencialmente el mismo que el de decidir si hay diferencias importantes entre los valores de la población y la muestra. Generalmente, las pruebas están basadas en la hipótesis nula de que no hay diferencias significativas entre la distribución muestral y la teórica.

miércoles, 19 de septiembre de 2012

Prueba de Kolmogorov-Smirnov de dos entradas-Edwin


Introducción
Dentro de la estadística se aplican en la investigación los tests o dócimas paramétricos y no paramétricos, el presente trabajo está dedicado al estudio de dos pruebas no paramétricas que por su importancia merecen ser tratadas de forma independiente, ellas son las pruebas de Kolmogorov-Smirnov para una y dos muestras.

BONDAD DE AJUSTE: TEST DE KRUSKAL WALLIS-Roxana


I. INTRODUCCIÓN

Existen series de procedimientos estadísticos diseñados para analizar variables cuantitativas: la prueba de T para contrasta hipótesis sobre medias o coeficientes de regresión, el estadístico F del análisis de varianza, etc. Todos ellos coinciden en una serie de características: a) Permiten contrastar hipótesis referida a algún parámetro (µ, δ2, β, etc), b) Exigen el cumplimiento de determinados supuestos sobre las poblaciones originales de las que se extraen los datos y c) Analizan datos obtenidos con una escala de medida de intervalo o razón.

miércoles, 12 de septiembre de 2012

La distribución Chi-cuadrado χ2 y las pruebas de independencia

Intervalos de confianza
Prueba de independencia
“En muchas ocasiones, los administradores necesitan saber si las diferencias que observan entre varias proporciones de la muestra son significativas o sólo se deben al azar.”(5:449) Si la diferencia entre las proporciones es significativa, el administrador puede llegar a la conclusión de que una variable afectara la forma en que debe de actuar la otra variable, pero si la diferencia no es significativa entonces puede decir que una de las variables no tendrá efecto sobre la otra variable. De lo anterior se puede indicar que la prueba de independencia “permitirá la comparación de dos atributos para determinar si existe una relación entre ellos.”
La prueba Chi-cuadrado de contingencia sirve para comprobar la independencia de frecuencias entre dos variables aleatorias, X e Y.

USO DE EXEL PARA REALIZAR LA DISTRIBUCION GAMMA-Fanny

Introducción
Una distribución de probabilidad es una lista del total de valores que puede tomar una variable aleatoria con una probabilidad asociada.
Existen dos tipos de distribuciones de probabilidad, las distribuciones de probabilidad discretas y las distribuciones de probabilidad continuas.
Las distribuciones de probabilidad continuas son aquellas en las que la variable aleatoria puede asumir un número infinito de valores, que son resultado de una medición. Por ejemplo, el valor de la temperatura media del aire en intervalos dados de tiempo. Por supuesto que las variables aleatorias continuas dependen de la exactitud del instrumento de medición en este caso del termómetro.

martes, 11 de septiembre de 2012

ESTACIONARIO, CONSISTENTE Y HOMOGÉNEO-Roxana


I. INTRODUCCIÓN
El estudio de la climatología tiene una estrecha relación con el estudio del cambio climático, el cambio de uso de suelo, el cambio en la cobertura vegetal y otros; éste tipo de estudios presentan a menudo datos que están sujetos a diversos tipos de errores, entre ellos los errores sistemáticos y errores aleatorios.
Los errores sistemáticos, son aquellos que pueden ser más o menos invariables en magnitudes. Se puede presentar por diversas fallas como ser: fallas en el método o técnica de cálculo, en el instrumento de observación, entre otros; esté tipo de errores pueden ser corregibles.
Los errores aleatorios, son aquello que ocurren al azar, no pueden ser controlados fácilmente y se deben aplicar estrategias para corregirlos, como por ejemplo el incremento del número de muestras o experimentos en la investigación.
Debido a la presencia común de estos errores en la toma de datos de estudios relacionados con la climatología, cambio climático, cambio del uso de suelos, etc., se realiza el análisis de calidad de datos en base a tres criterios, es decir, los datos deben ser: Estacionarios, Consistentes y Homogéneos.
En el presente reporte se muestra las partes más relevantes de un paper relacionado con investigación en escenarios de cambio climático en el Altiplano Peruano en donde se analiza los datos en base a los 3 criterios sobre calidad de datos para interpretar y mostrar sus resultados:

martes, 4 de septiembre de 2012

DISTRIBUCIÓN HIPERGEOMETRICA Y DISTRIBUCIÓN INVERSA LOGARÍTMICA


 DISTRIBUCIÓNN HIPERGEOMETRICA

En esta distribución se extrae una muestra “n” de una población “N”, pero en esa selección de la muestra existen x éxitos de r éxitos de la población. Es decir, ¿Cuál es la probabilidad de que en la selección de la muestra existan éxitos dado que en la población hay éxitos? Recordemos que la variable aleatoria hipergeométrica “X” es él Éxito en n (muestra). Observe y analice el gráfico:
Características:

domingo, 2 de septiembre de 2012

LAS PRUEBAS DE CONSISTENCIA Y HOMOGENEIDAD RELATIVA_Fanny

         Una serie de tiempo de datos hidrológicos es relativamente constante si los datos son periódicamente proporcionales a una serie de tiempo apropiado simultáneamente  (Chang y Lee 1974). La  consistencia relativa significativa que los datos hidrológicos en una observación  cierta estación son generados por el mismo mecanismo que genera similares  datos de otras estaciones. Es una práctica común para verificar 

sábado, 1 de septiembre de 2012

Test de corrida para prueba de aleatoriedad-Freddy1

   Todos los métodos de inferencia se basan en la suposición de que las muestras son aleatorias; no obstante, hay muchas aplicaciones en que es difícil decidir si la suposición es justificable. Esto es verdadero, particularmente, cuando tenemos poco control o ninguno sobre la selección de los datos, como es el caso, por ejemplo, cuando confiamos en cualquier registro disponible para hacer pronósticos de largo alcance sobre el clima, cuando usamos cualquier dato disponible para estimar la tasa de mortalidad como consecuencia de una enfermedad o cuando usamos los registros de ventas del mes pasado para pronosticar las ventas de una tienda de departamentos. Ninguna de estas informaciones constituye una muestra aleatoria en forma estricta.
Related Posts Plugin for WordPress, Blogger...